

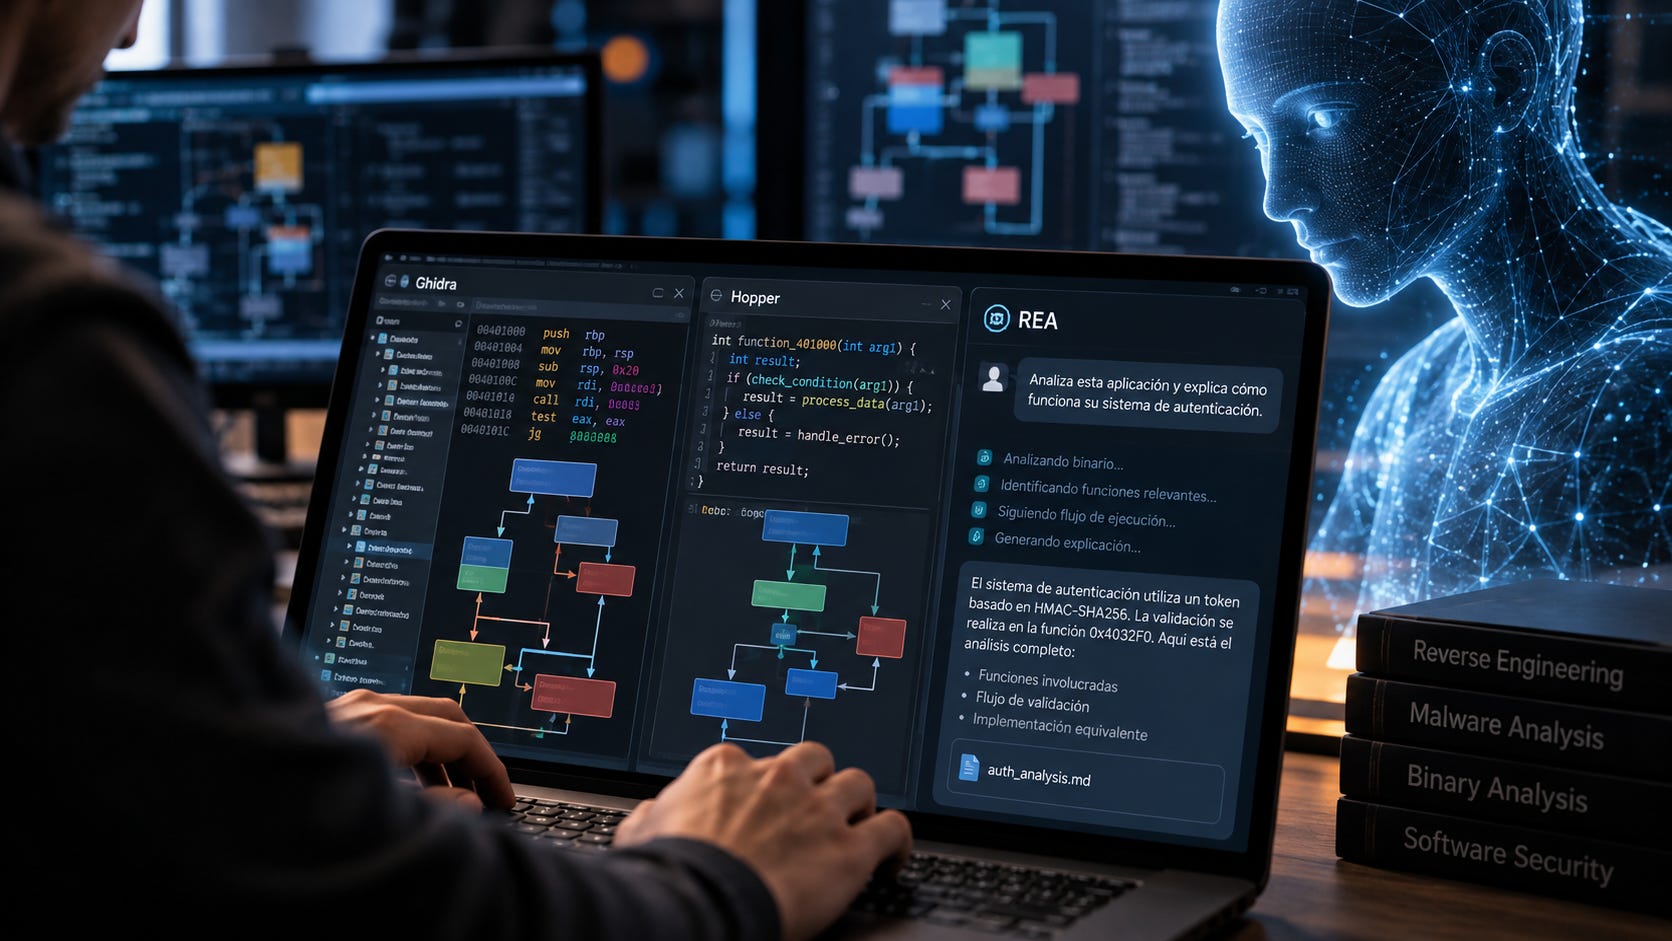
Su objetivo es permitir que agentes de IA investiguen aplicaciones, comprendan su funcionamiento y reconstruyan funcionalidades sin disponer del código fuente original.
La ingeniería inversa de software ha sido históricamente una disciplina que exige conocimientos especializados, herramientas complejas y numerosas horas de análisis. Comprender cómo funciona una aplicación sin acceder a su código fuente implica examinar archivos ejecutables, interpretar instrucciones de bajo nivel y reconstruir manualmente la lógica de sus componentes.
Un proyecto de código abierto llamado REA (Reverse Engineer Anything) busca transformar ese proceso mediante agentes de inteligencia artificial capaces de interactuar directamente con herramientas de análisis y desarrollar investigaciones guiadas por objetivos.

La herramienta, distribuida bajo licencia MIT, utiliza el protocolo Model Context Protocol (MCP) para conectar asistentes de programación con motores de ingeniería inversa. De esta manera, un investigador puede solicitarle a un agente que examine una aplicación, identifique cómo funciona determinada característica y presente sus conclusiones acompañadas de evidencia técnica.
El proyecto no pretende reemplazar las herramientas tradicionales, sino proporcionar una capa de automatización que permita utilizarlas de manera coordinada.
De analizar código a conversar con una aplicación
La propuesta de REA parte de una idea relativamente sencilla: en lugar de navegar manualmente por miles de funciones, referencias y estructuras de datos, el investigador describe qué quiere comprender y deja que un agente de IA organice buena parte del trabajo.
Por ejemplo, un desarrollador podría solicitar que se investigue cómo funciona el sistema de búsqueda sin conexión de una aplicación de notas.
A partir de esa instrucción, el agente puede identificar los archivos relevantes, examinar sus componentes, localizar funciones relacionadas con la búsqueda y seguir las conexiones entre ellas.
El proceso se organiza en tres etapas principales:
Descompilar: examinar los archivos de la aplicación para recuperar representaciones legibles de código, cadenas de texto, símbolos y otras pistas sobre su funcionamiento.
Comprender: relacionar esos elementos para reconstruir el comportamiento de una funcionalidad, identificando llamadas entre funciones, dependencias y flujos de ejecución.
Recrear: utilizar el conocimiento obtenido para desarrollar una implementación equivalente, adaptada a otro proyecto o entorno tecnológico.
Esta última etapa resulta especialmente interesante porque conecta directamente la investigación técnica con el desarrollo de software.
Sin embargo, existe una distinción fundamental: REA no recupera necesariamente el código fuente original ni garantiza que pueda clonar automáticamente una aplicación. Lo que proporciona es un procedimiento para investigar su comportamiento y producir implementaciones basadas en los resultados del análisis.
Ghidra, Hopper y múltiples tecnologías bajo una misma interfaz
Uno de los principales atractivos del proyecto es su capacidad para integrar diferentes herramientas y técnicas de análisis.
Para investigar ejecutables nativos, REA puede utilizar motores como Ghidra y Hopper, que permiten obtener representaciones de código descompilado, instrucciones ensamblador, referencias cruzadas y relaciones entre funciones.
En lugar de obligar al investigador a trasladar manualmente información entre herramientas, el agente puede solicitar esos datos mediante una interfaz común y utilizarlos para continuar su investigación.
El alcance también se extiende más allá de los ejecutables tradicionales.
Entre las capacidades documentadas se encuentran el análisis de aplicaciones JavaScript y Electron, la inspección de metadatos y código intermedio de .NET, y la observación controlada de determinados comportamientos durante la ejecución.
Esto permite abordar aplicaciones compuestas por múltiples capas tecnológicas, donde una funcionalidad aparentemente sencilla puede involucrar código JavaScript, comunicaciones entre procesos y bibliotecas nativas.
La documentación también contempla distintos flujos de análisis de artefactos, aunque su disponibilidad depende de la plataforma, las herramientas instaladas y el grado de madurez de cada integración.
Por lo tanto, el nombre Reverse Engineer Anything debe entenderse como la aspiración del proyecto, no como una garantía de compatibilidad universal.
Resultados verificables, no solamente respuestas de una IA
Uno de los aspectos más relevantes de REA es su enfoque en la trazabilidad de los resultados.
Los modelos de lenguaje pueden generar explicaciones técnicamente convincentes que, sin embargo, contienen errores o interpretaciones sin fundamento.
En ingeniería inversa, este problema es particularmente delicado. Una interpretación incorrecta del comportamiento de una función puede comprometer toda una investigación.
REA intenta reducir ese riesgo mediante un modelo que distingue entre los datos obtenidos de las herramientas de análisis y las conclusiones elaboradas por el agente.
Los resultados pueden incluir referencias a funciones, instrucciones, relaciones entre componentes y otras evidencias que permiten revisar las conclusiones.
El proyecto presenta demostraciones de este enfoque. En una de ellas, relacionada con el videojuego DX-Ball, se reconstruyó una función de cálculo de posición del sonido y se verificó su comportamiento mediante 3.205 casos de prueba sobre la implementación original en x86.
Según la documentación publicada, la reconstrucción también reprodujo los 63 bytes de la función compilada.
Otra demostración examina el funcionamiento del portapapeles de Notion, siguiendo las interacciones entre los diferentes componentes de su arquitectura Electron.
Estos ejemplos muestran cómo un agente puede pasar de identificar una funcionalidad a reconstruirla y contrastar los resultados mediante pruebas.
No obstante, se trata de demostraciones específicas y no constituyen evidencia de que la herramienta pueda reproducir con la misma precisión cualquier aplicación.
¿Qué cambia para los investigadores de seguridad?
La incorporación de agentes de IA a los procesos de ingeniería inversa abre posibilidades para distintas actividades de ciberseguridad.
En el análisis de malware, por ejemplo, un investigador podría utilizar estas capacidades para localizar funciones relacionadas con comunicaciones de red, persistencia o manipulación de archivos.
En auditorías de seguridad, podrían facilitar la comprensión de componentes propietarios cuando no existe acceso al código fuente.
También podrían resultar útiles para estudiar protocolos no documentados, investigar vulnerabilidades en aplicaciones o comprender dependencias tecnológicas utilizadas por sistemas heredados.
El principal cambio no consiste en eliminar la necesidad de conocimientos técnicos, sino en reducir el trabajo manual necesario para reunir, relacionar e interpretar evidencias.
Esto podría permitir que investigadores experimentados dediquen más tiempo a formular hipótesis y validar hallazgos, mientras los agentes realizan parte de las tareas repetitivas.
Al mismo tiempo, estas capacidades podrían reducir las barreras de entrada para personas con menos experiencia en ingeniería inversa.
Esa accesibilidad tiene una contrapartida: las mismas herramientas que facilitan las investigaciones legítimas también pueden utilizarse para estudiar mecanismos de protección, descubrir debilidades o comprender aplicaciones con fines maliciosos.
Como sucede con otras tecnologías de doble uso, el impacto depende tanto de las capacidades disponibles como de quién las utiliza y con qué objetivos.
El desafío de la privacidad y la ejecución segura
Aunque REA está diseñado para realizar el análisis en el equipo local, esto no significa necesariamente que toda la información permanezca dentro de ese entorno.
La herramienta no requiere enviar el ejecutable completo a un servicio de análisis remoto. Sin embargo, cuando se utiliza un agente conectado a un modelo de IA alojado por un tercero, los resultados de la investigación pueden transmitirse como parte del contexto necesario para procesar las solicitudes.
Esta distinción es importante cuando se trabaja con aplicaciones propietarias, software confidencial o componentes de infraestructura crítica.
También existen riesgos asociados con el análisis dinámico.
A diferencia de la inspección estática, que examina archivos sin ejecutarlos, determinadas operaciones de observación requieren iniciar procesos o interactuar con aplicaciones.
La documentación del proyecto advierte que varios de estos mecanismos operan con los permisos del usuario y no constituyen entornos de aislamiento de seguridad.
Por esa razón, analizar software potencialmente malicioso exige mantener las precauciones habituales, incluyendo el uso de entornos controlados y mecanismos de aislamiento adecuados.
La automatización mediante IA no elimina los riesgos de ejecutar código desconocido.
Una nueva etapa para la ingeniería inversa
REA representa una tendencia que comienza a consolidarse en el desarrollo de herramientas de seguridad: utilizar agentes de inteligencia artificial como intermediarios entre el investigador y los instrumentos técnicos especializados.
En este modelo, la IA no necesita reemplazar al descompilador, al depurador ni al analista. Su función consiste en coordinar herramientas, interpretar resultados y proponer los siguientes pasos de una investigación.
El enfoque también plantea una cuestión relacionada con la independencia tecnológica.
Facilitar el análisis de software sin disponer del código fuente puede contribuir a comprender mejor componentes propietarios, documentar sistemas heredados y reducir ciertas dependencias respecto de sus fabricantes.
Sin embargo, cuando ese análisis depende de modelos de inteligencia artificial externos, aparece una nueva dependencia tecnológica que debe considerarse, especialmente en organizaciones que manejan información sensible.
La verdadera utilidad de herramientas como REA dependerá de su capacidad para producir resultados reproducibles, mantener límites de seguridad claros y permitir que los investigadores conserven el control sobre las decisiones técnicas.
La ingeniería inversa no deja de requerir conocimientos especializados. Lo que empieza a cambiar es cuánto trabajo necesita realizar manualmente una persona para comprender qué ocurre dentro de un programa.